Assistants
KI-Assistenten-Endpunkte
https://app.meingpt.com/api/assistants/v1/Verfügbare Assistenten abrufen
Ruft alle Assistenten ab, die dem authentifizierten Benutzer zur Verfügung stehen
🔒 ApiKeyAuth
Parameter
| Parameter | In | Typ | Beschreibung |
|---|---|---|---|
| Authorization* | header | string | API-Schlüssel zur Authentifizierung. Verwende das Format 'Bearer <Dein-API-Schlüssel>'. |
Responses
| Feld | Typ | Beschreibung |
|---|---|---|
| assistants | Array<object> |
| Feld | Typ | Beschreibung |
|---|---|---|
| status | string | |
| message | string |
https://app.meingpt.com/api/assistants/v1/{assistantId}/runEinen Assistenten ausführen
Führt einen Assistenten mit den bereitgestellten Nachrichten aus und gibt die Antwort des Assistenten mit Tool-Aufrufen und Begründungen zurück. Alternativ kannst Du auch `multipart/form-data` verwenden, um Dateien mitzugeben. Dabei wird `messages` als JSON-String gesendet und Dateien über `files` hochgeladen.
🔒 ApiKeyAuth
Parameter
| Parameter | In | Typ | Beschreibung |
|---|---|---|---|
| Authorization* | header | string | API-Schlüssel zur Authentifizierung. Verwende das Format 'Bearer <Dein-API-Schlüssel>'. |
| assistantId* | path | string | Die Assistenten-ID |
Request Body · application/json
| Feld | Typ | Beschreibung |
|---|---|---|
| messages* | Array<ChatMessage> |
Responses
| Feld | Typ | Beschreibung |
|---|---|---|
| text | string | Antworttext des Assistenten |
| model | string | Verwendetes Modell für die Generierung |
| messages | Array<object> | Antwortnachrichten des Assistenten inkl. Tool-Aufrufen und Begründungen |
| usage | object | |
| citations | Array<string> | Zitate aus Tool-Nutzung |
| Feld | Typ | Beschreibung |
|---|---|---|
| status | string | |
| message | string |
| Feld | Typ | Beschreibung |
|---|---|---|
| status | string | |
| message | string |
| Feld | Typ | Beschreibung |
|---|---|---|
| status | string | |
| message | string |
Zeitverhalten bei synchronen API-Aufrufen
Ein Assistenten-Lauf über die API läuft synchron und stellt keinen separaten Status- oder Polling-Endpunkt bereit. Die Anfrage bleibt offen, bis der Assistent fertig ist oder ein Infrastruktur-Timeout eintritt, typischerweise nach ca. fünf Minuten. Das ist unabhängig vom Timeout Deines eigenen HTTP-Clients — ist dessen Timeout kürzer, bricht er die Verbindung zuerst ab, und Du bekommst die Antwort des Assistenten nie zu sehen, auch wenn der Lauf serverseitig weiterlief. Konfiguriere das Timeout Deines Clients so, dass es die erwartete Laufzeit abdeckt. Bei der Verarbeitung großer oder mehrerer Dateien, komplexen Werkzeug-Aufrufen oder umfangreichen Ausgaben kann ein Lauf dieses Zeitfenster erreichen. Plane für lang laufende Aufrufe entsprechend, oder löse sie asynchron über eine externe Automatisierung (z. B. Make) aus, die den Abschluss separat prüft.
Dateien an einen Assistenten-Lauf anhängen
Du kannst einem Assistenten-Lauf Dateien mitgeben. Das Größenlimit liegt bei 50 MB pro Datei; Details stehen in der API-Referenz.
Hinweis
Konnektoren (z. B. Outlook, SharePoint, Confluence), die an einen Assistenten angebunden sind, stehen auch bei einem Assistenten-Lauf über die externe API zur Verfügung. Sie werden gegen die Verbindungen des Nutzer-Accounts aufgelöst, dem der verwendete API-Key gehört — dieser Account muss den Dienst also selbst verbunden haben. Das gilt für jede persönliche Verbindung (OAuth-Konnektoren und eigene MCP-Server): Verbindungen anderer Mitglieder werden nie herangezogen, und ist der Konnektor unter dem Account des API-Keys nicht verbunden, läuft der Assistent einfach ohne ihn. Ausgenommen sind im Team geteilte eigene MCP-Server, die sich über fest hinterlegte Header authentifizieren: Sie wirken wie ein Service-Account und funktionieren für jeden Aufrufer — genau wie im Chat.
Für eingebaute Tools gilt eine eigene, strengere Regel:
Achtung
Auch bestimmte eingebaute Tools stehen bei einem Assistenten-Lauf über die externe API nicht automatisch zur Verfügung, selbst wenn sie im interaktiven Chat für denselben Assistenten sichtbar sind: Websuche, Code Sandbox, Foliengenerierung, Artefakte (Dokumente) und Bildgenerierung werden im Chat teils nur über einen chat-weiten Schalter aktiviert und sind nicht dauerhaft am Assistenten gespeichert. Über die API stehen sie nur zur Verfügung, wenn sie explizit als Tool am Assistenten selbst hinterlegt sind (Reiter "Tools" im Assistenten-Editor). Datenpools, direkt am Assistenten hochgeladene Dateien und die Meetings-Wissensquelle sind davon nicht betroffen - sie sind am Assistenten selbst gespeichert und funktionieren über die API genauso wie im Chat.
Hinweis
Datenpools (Wissensquellen / RAG), die an einen Assistenten angebunden sind, stehen ebenfalls bei einem Assistenten-Lauf über die externe API zur Verfügung. Voraussetzung ist, dass der Nutzer-Account, dem der verwendete API-Key gehört, selbst Zugriff auf den jeweiligen Datenpool hat (siehe Abschnitt "Zugriffskontrolle" im Datenpools-Dokument) – unabhängig davon, mit wem der Assistent selbst geteilt wurde. Die Freigabe prüfst oder änderst Du unter Einstellungen → Datenquellen, ein Bereich, der nur für Workspace-Admins sichtbar ist. Bist Du selbst kein Admin, bitte eine:n Admin, die Freigabe für den betroffenen Datenpool zu prüfen, auch wenn Du den Assistenten selbst erstellt hast.
Zugriff auf den Denkprozess (Reasoning) des Modells
Bei Modellen mit sichtbarem Denkprozess (siehe "Reasoning-Tag" bei Modelle) steckt dieser Denkprozess in der messages-Liste der Lauf-Antwort, nicht in text. Er erscheint als ein oder mehrere Content-Teile vom Typ "reasoning" innerhalb einer Assistant-Nachricht, neben "text"-Teilen und eventuellen Tool-Aufrufen:
{
  "role": "assistant",
  "content": [
    { "type": "reasoning", "text": "..." },
    { "type": "text", "text": "..." }
  ]
}
Um ihn auszulesen, iterierst du über messages, behältst die Einträge mit role: "assistant" und sammelst den text jedes Content-Teils mit type: "reasoning".
Das gilt nur für die Assistenten-Lauf-API. Die Completions-API liefert keinen Reasoning-Inhalt zurück - ihre Antwort enthält nur choices[0].message.content und tool_calls, ohne entsprechendes Feld.
Ob Reasoning-Teile vorhanden sind und wie detailliert sie ausfallen, hängt vom Modell und seinem Reasoning-Aufwand ab - manche Modelle denken intern, ohne einen sichtbaren Trace auszugeben, und der Reasoning-Aufwand/-Level lässt sich über die API aktuell nicht einstellen (siehe Completions).
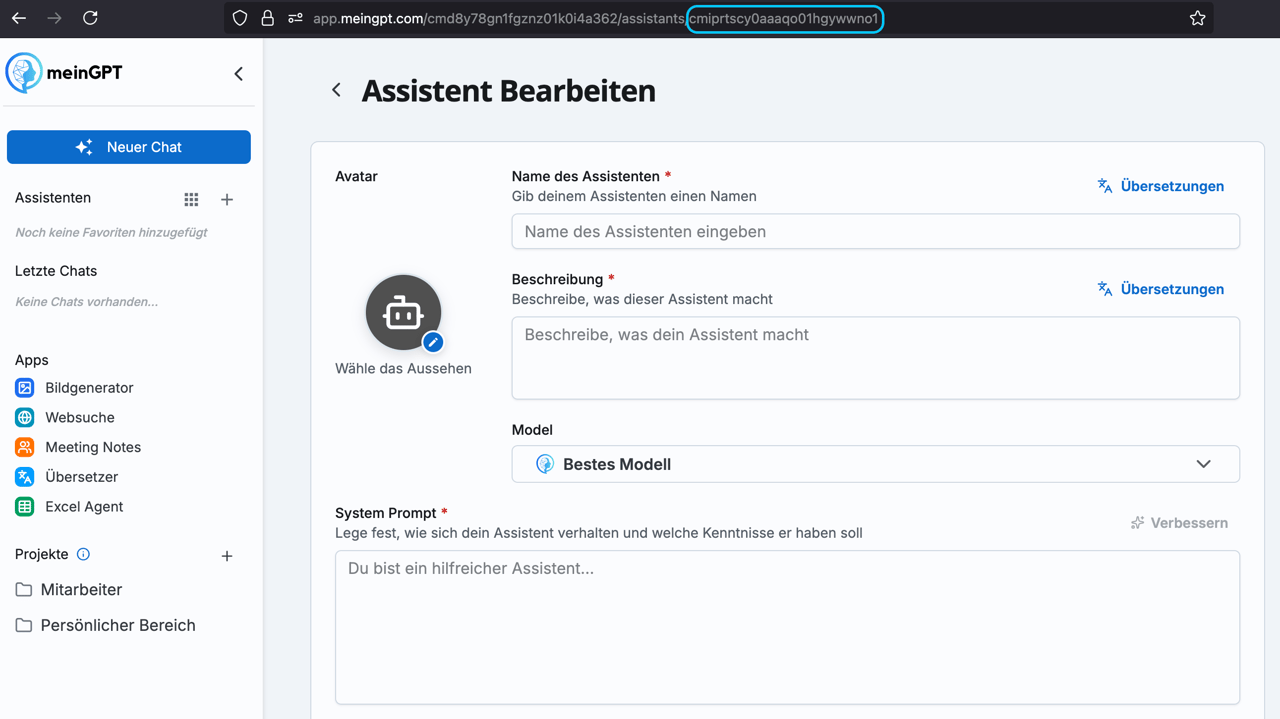
AssistantId finden
- Gehe in den Bearbeitungsmodus deines Assistenten
- In der URL findest du hinter
/assistants/die AssistantId